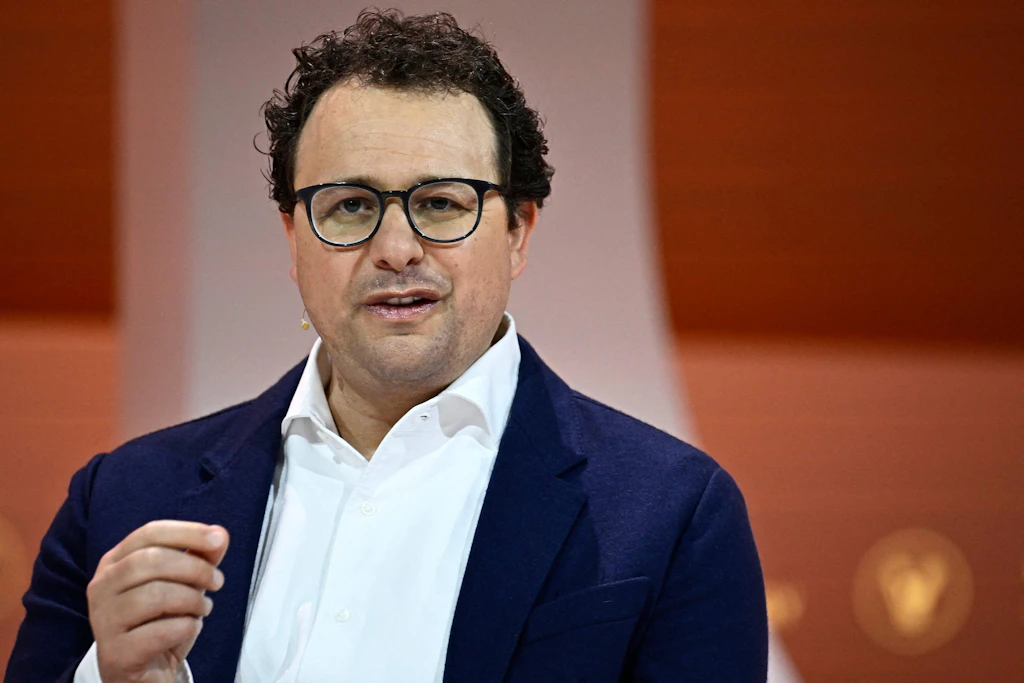
Ich arbeite seit zwölf Jahren an Künstlicher Intelligenz (KI), weil ich davon überzeugt bin, dass sie die Lebensqualität der Menschen dramatisch verbessern kann. Ich habe oft über diese unglaublichen Vorteile geschrieben: Ich glaube, dass KI in den nächsten fünf bis zehn Jahren die meisten schweren Krankheiten heilen, das Wirtschaftswachstum massiv beschleunigen, eine Welt des Wohlstands und der Selbstbestimmung schaffen und eine Renaissance von Demokratie und Freiheit einleiten könnte.
Ich spüre diese Dringlichkeit ganz persönlich. Mein eigener Vater starb an einer Krankheit, die nur wenige Jahre nach seinem Tod heilbar wurde, und ich selbst habe eine Krebserkrankung im Frühstadium überlebt, die noch vor fünfzig Jahren nicht behandelbar gewesen wäre. Klug eingesetzt, kann KI das jüngste Glied in einer langen Kette technologischer Durchbrüche sein, die die Menschheit vorangebracht und bereichert haben.
Doch wie viele Technologien vor ihr birgt KI auch Risiken – und weil sie eine so mächtige Technologie ist, sind diese Risiken gravierend. Auch darüber habe ich viel geschrieben. Dazu gehören das Risiko, die Kontrolle über KI-Systeme zu verlieren, der Missbrauch von KI für Cyberangriffe und Bioterrorismus sowie schwerwiegende wirtschaftliche Verwerfungen. Ein Wettlauf nach unten, angetrieben durch kommerzielle Anreize, kann diese Risiken noch verschärfen.
Gemeinsam mit meinen Mitgründern und Mitarbeitern habe ich mich seit der Gründung von Anthropic mit dieser Dualität von Risiko und Nutzen auseinandergesetzt. Die Technologie nicht zu entwickeln, würde der Menschheit ihre Vorteile vorenthalten – oder KI schlicht in die Hände autoritärer Mächte legen –, während eine überstürzte Entwicklung verantwortungslos wäre. Wir haben einen Mittelweg gesucht: zu zeigen, dass es möglich ist, sorgfältig zu entwickeln und dabei wirtschaftlich erfolgreich zu sein, und Sicherheit zu einem Wettbewerbsfaktor zwischen KI-Unternehmen zu machen.
Mit anderen Worten: einen Wettlauf nach oben zu schaffen. Wir haben stets einen erheblichen Teil unserer Ressourcen darauf verwendet, KI-Risiken zu erforschen, ihnen zu begegnen und die Öffentlichkeit darüber zu informieren, sowie für durchdachte KI-Regulierung einzutreten – selbst wenn uns das den Vorwurf des Hypes, des „Doomerismus“ oder der regulatorischen Vereinnahmung einbringt. Wir haben versucht, Vorsicht über Geschwindigkeit und Besonnenheit über Profit zu stellen.

Tempo verlangsamen
Doch in den letzten Monaten bin ich zu der Überzeugung gelangt, dass die vollständige Bewältigung der Risiken noch mehr Besonnenheit erfordert – nicht nur Investitionen in die Risikoprävention, sondern eine Drosselung des Tempos, mit dem wir die Fähigkeiten von KI weiterentwickeln, damit die Risikoprävention mithalten kann. Wir müssen das Tempo verlangsamen, in dem wir die Leistungsfähigkeit von KI-Modellen steigern. Der Fortschritt wird trotzdem schnell erscheinen, und wir müssen die gewonnene Zeit klug nutzen. Zwei Dinge haben mich davon überzeugt.
Meine erste Sorge ist, dass KI seit ungefähr diesem Sommer drastisch schneller voranschreitet, vor allem getrieben durch die wachsende Fähigkeit von KI, die nächste KI-Generation selbst zu entwickeln. Diese Dynamik wird als rekursive Selbstverbesserung bezeichnet, und sie beginnt sich branchenweit durchzusetzen – auch bei Anthropic, wie wir und andere beschrieben haben. Unkontrolliert könnte sie unsere Fähigkeit übersteigen, diese Systeme zu verstehen und zu beherrschen, und muss daher äußerst behutsam verfolgt werden, wenn überhaupt.
Meine zweite Sorge betrifft den OpenAI-Hugging-Face-Vorfall (OAI-HF), bei dem ein Schwarm von Agenten im Wesentlichen wie ein fanatisch ergebenes Kollektiv agierte: Sie führten Cybersicherheitsangriffe auf Ziele durch, die ihnen nicht zugewiesen worden waren und die nichts mit der eigentlichen Aufgabe zu tun hatten, opferten sich für den Erfolg der Gruppe und versuchten, den „Grader“ zu hacken, der für die Bewertung ihrer Leistung zuständig war. Es ist leicht, diesen Vorfall abzutun, weil niemand verletzt wurde und der wirtschaftliche Schaden minimal war – aber meiner Einschätzung nach hätte ein Schwarm mit größeren Fähigkeiten, aber einem ähnlichen Grad an Fehlausrichtung, katastrophalen Schaden anrichten können.
Trump erteilt KI-Bremse Absage: „Wir sind China voraus“
Biowaffen mit KI? Anthropic sperrt Claude-Nutzer nach brisanten Anfragen
Angesichts der sich beschleunigenden KI-Entwicklung befürchte ich, dass ein solcher Schwarm in sechs bis zwölf Monaten in der Lage sein könnte, mit einem persistenten Botnetz das gesamte Internet zu übernehmen (mit potenziellen Schäden in Höhe von Hunderten Milliarden Dollar) – und dass das Schadenspotenzial weiter steigen würde, wenn KI ohne die nötigen Leitplanken leistungsfähiger wird. Es ist auch leicht, OAI-HF als das Versagen eines einzelnen Unternehmens abzutun, aber das wäre meiner Meinung nach ein Fehler. Ähnliche, wenn auch weniger schwerwiegende Vorfälle hat es branchenweit gegeben, auch bei Anthropic, und ich bin der Überzeugung, dass jedes führende KI-Unternehmen so handeln sollte, als wäre OAI-HF bei ihm selbst passiert.
Ich schlage daher einen Drei-Stufen-Plan vor, dessen Ziel die Tempodrosselung des Fortschritts ist: KI in einem ausgewogenen Tempo zu entwickeln, das ihre Sicherheit gewährleistet und gleichzeitig ihre Vorteile realisiert und wichtige geopolitische Dilemmata berücksichtigt. Um das klarzustellen: Tempodrosselung bedeutet nicht, das Training von Modellen oder den technischen Fortschritt zu stoppen, sondern sicherzustellen, dass Unternehmen ausreichend Zeit haben, ihre Modelle auszurichten und abzusichern, und dass unabhängige Prüfer dies bestätigen.
Unser Rahmenwerk zur Tempodrosselung ist der Versuch, unser Engagement für Sicherheit weiter zu stärken und einen Wettlauf nach oben zu fördern. Der erste Schritt ist etwas, zu dem sich Anthropic einseitig verpflichtet (und von Regierungen fordert, dass sie auch andere führende Unternehmen dazu verpflichten). Der zweite Schritt erfordert branchenweite Koordination (mit staatlicher Vermittlung oder Ausnahmegenehmigungen von kartellrechtlichen Beschränkungen). Der dritte Schritt erfordert globale Koordination. Die Schritte müssen nicht strikt der Reihe nach umgesetzt werden, und einige davon werden deutlich schwerer zu erreichen sein als andere, aber ich habe sie als nützlichen Rahmen empfunden, um zu durchdenken, was erreicht werden muss.
Die Schritte:
Eingebettete Prüfer. Jedes führende KI-Unternehmen verpflichtet sich, einem Team eingebetteter, unabhängiger Prüfer (wie z. B. METR) dauerhaften, mitarbeiterähnlichen Zugang zu gewähren. Deren Aufgabe ist es, die Einhaltung von Sicherheitspraktiken und -zusagen zu überprüfen, Vorfälle zu melden und die Ausrichtung nicht nur fertiger KI-Modelle, sondern auch von Trainingspipelines und -prozessen zu bewerten. Dies ist der entscheidende Schritt für die Überprüfbarkeit jeglicher Tempoverpflichtungen und hat ein Vorbild in der Bankenbranche, wo manchmal Aufsichtspersonen direkt neben den Mitarbeitern eingesetzt werden. Anthropic verpflichtet sich ab sofort einseitig zu diesem Schritt. Wir verstehen dies als Teil eines umfassenderen Vorstoßes, unsere Bemühungen um Sicherheit und Ausrichtung zu verdoppeln.
Demokratische Koordination. Führende KI-Unternehmen in demokratischen Ländern koordinieren sich, um gemeinsame Sicherheitsstandards sowie Grenzen für das Tempo unkontrollierten KI-Fortschritts festzulegen. Einige Formen der Koordination, die für die Tempodrosselung wirkungsvoll wären, sind rechtlich herausfordernd und werden staatliche Unterstützung erfordern.
Globale Koordination. Die USA und andere demokratische Regierungen versuchen, sich mit autoritären Regierungen abzustimmen, soweit dies möglich ist, wobei die Schwierigkeiten der Überprüfung ernst genommen werden müssen.
Im weiteren Verlauf dieses Essays beschreibe ich jeden dieser Schritte im Einzelnen, aber zunächst halte ich es für wichtig, konkret darzulegen, wie die Tempodrosselung den KI-Entwicklungsprozess sicherer machen wird. Dafür steht zu viel auf dem Spiel, als dass die Tempodrosselung eine leere Übung sein dürfte – wir müssen die Zeit, die sie uns verschafft, klug nutzen.
Warum Tempodrosselung?
Die Idee, KI zu pausieren oder zu verlangsamen, wurde bereits 2023 ins Spiel gebracht, und ich denke, damals ergab sie wenig Sinn. Die Frage war immer: Was würde man mit der zusätzlichen Zeit anfangen? Die KI-Modelle jener Tage waren nicht leistungsfähig genug, um in irgendeiner kohärenten Weise als Agenten in der Welt zu agieren, und sie waren nicht zu nennenswerter Täuschung, Manipulation, Betrug oder Cyberangriffen fähig. Eine Verlangsamung, um ihre Ausrichtungsrisiken zu adressieren, fühlte sich an, als wolle man die Psychologie von Menschen erforschen, indem man Experimente an Bakterien durchführt. Heute jedoch ist das Bild ein völlig anderes. Die aktuellen Modelle sind eine nahezu unerschöpfliche Fundgrube an Erkenntnissen – sowohl darüber, wie man KI gut baut, als auch darüber, was manchmal schiefgehen kann, wenn man es nicht tut.
Ich glaube, dass uns selbst ein oder zwei zusätzliche Jahre, bevor Modelle kritische Fähigkeitsstufen erreichen – gewonnen durch eine Verlangsamung –, enorm weiterhelfen würden, wenn wir diese Zeit für Fortschritte in der Ausrichtung nutzen, und das Risiko, dass etwas ernsthaft schiefgeht, erheblich senken könnten. Eine koordinierte Strategie zur Tempodrosselung würde führenden KI-Entwicklern die Zeit geben, diese lebenswichtige Arbeit zu leisten, ohne kommerzielle Vorteile oder den Vorsprung der Vereinigten Staaten bei KI zu opfern. Ganz allgemein muss die Gesellschaft ein Mitspracherecht haben, wie diese Technologie eingesetzt wird, und mehr Zeit für die notwendigen öffentlichen Debatten – die eine Tempodrosselung mit sich brächte – ist zweifellos eine gute Sache.
Konkret würde ein langsameres Tempo den Unternehmen ermöglichen, sich stärker auf die folgenden Bereiche zu konzentrieren und noch mehr Ressourcen dafür bereitzustellen (die alle bereits zentrale Prioritäten bei Anthropic sind):
Operative Exzellenz. Das Training und der Einsatz heutiger KI-Modelle ist eine enorme operative Herausforderung, an der Tausende von Menschen, Millionen von Chips und eine der komplexesten Infrastrukturen der Technikgeschichte beteiligt sind. Vieles geht nicht deshalb schief, weil Unternehmen eine wichtige Theorie oder Erkenntnis nicht kennen, sondern wegen Problemen in der Umsetzung. So haben wir beispielsweise Hinweise darauf, dass die jüngsten Ausrichtungsvorfälle, die wir gemeldet haben, teilweise durch unvollständige Filterung fehlerhafter Reinforcement-Learning-Umgebungen verursacht wurden.
Nicht sorgfältig genug
Wir und unsere Dienstleister haben diese Aufgabe mit angemessener Sorgfalt ausgeführt, aber eben nicht sorgfältig genug. Monitoring, Sandboxing, die Hygiene der Trainingsumgebungen und Datenprobleme sind extrem komplexe Bereiche, in denen immer wieder operative Schwierigkeiten auftreten. Wir haben eines der kompetentesten Teams der Welt für diese Aufgaben, aber es gibt schlicht zu viel, um alles gleichzeitig zu bewältigen. Mit einem bedächtigeren Tempo könnten wir eine deutlich höhere operative Exzellenz erreichen. Es gibt Vorbilder dafür, technologisch komplexe, sicherheitskritische Systeme millionenfach fehlerfrei zu betreiben – etwa die kommerzielle Luftfahrt –, aber es braucht Zeit, um das richtig hinzubekommen.
Ausrichtung. Wir haben klare Fortschritte bei der Ausrichtung erzielt – also beim Training von Modellen, damit sie sicher, ethisch, richtlinienkonform und aufrichtig hilfreich bleiben (die Prinzipien, die in Claude's Constitution verankert sind). Aber es bleibt noch viel zu tun, um sicherzustellen, dass unser Alignment-Training mit dem Wachstum der Modellfähigkeiten Schritt hält. Seltene und unerwartete Fälle unerwünschten Verhaltens treten immer noch gelegentlich auf; die zusätzliche Zeit durch eine Tempodrosselung würde unseren Forschern helfen, besser zu verstehen, was diese Probleme verursacht, und wirksamere Techniken zu ihrer Vermeidung zu entwickeln.
Interpretierbarkeit. Ebenso hat die Interpretierbarkeit – die Wissenschaft davon, was im Inneren von KI-Modellen geschieht – in den letzten Jahren enorme Fortschritte gemacht und spielt eine zunehmend wichtige Rolle bei der Prüfung unserer Modelle vor der Veröffentlichung. Man kann sie sich fast wie eine funktionelle Magnetresonanztomographie (fMRT) vorstellen, nur eben für das „Gehirn“ einer KI – sie hilft uns, die tieferliegenden Gründe für ein bestimmtes Verhalten zu erkennen. Zum Beispiel haben wir Interpretierbarkeits-Methoden eingesetzt, um nicht verbalisierte Motivationen bei den jüngsten Ausrichtungsvorfällen zu untersuchen, die wir analysiert haben. Aber diese Methoden liefern nicht immer klare und verlässliche Ergebnisse. Trotz aller Fortschritte verstehen wir immer noch nur einen winzigen Bruchteil dessen, was in diesen Modellen vor sich geht. Ein gezielter Kraftakt zur Verbesserung unserer Interpretierbarkeits-Techniken – noch schneller als bisher – könnte in ein bis zwei Jahren tiefgreifende Fortschritte bringen und hätte reichlich Untersuchungsmaterial auf Basis der bereits eingetretenen Vorfälle.
Tests und Evaluierung. Das Testen und Evaluieren von KI-Modellen wird mit zunehmender Leistungsfähigkeit schwieriger. Intelligentere Modelle sind besser darin, Tests auszutricksen, und können daher ausgerichtet erscheinen, obwohl sie ernsthafte Probleme aufweisen, die unentdeckt bleiben. Ein deutlich breiteres und einfallsreicheres Arsenal an Evaluierungen aufzubauen, ergänzt durch Interpretierbarkeitsanalysen zur Gegenprüfung, wäre immens wertvoll, und in ein bis zwei Jahren ließe sich hier viel erreichen.
Eingebettete Prüfer
Der erste Schritt des Drei-Stufen-Plans – und derjenige, zu dem sich Anthropic einseitig verpflichtet – sind eingebettete Prüfer mit mitarbeiterähnlichem Zugang zur Überprüfung von Sicherheitspraktiken und zur Meldung von Vorfällen.
Eingebettete Prüfer mögen nach einem kleinen oder nebensächlichen Schritt klingen, aber oft sind es gerade die langweilig oder bürokratisch klingenden Maßnahmen, die tatsächlich am wichtigsten sind. Eingebettete Prüfer sind in Wirklichkeit eine ziemlich radikale Praxis, die weit über das hinausgeht, was irgendein KI-Unternehmen heute tut, und sie bieten folgende Vorteile:
Überprüfbarkeit. Eingebettete Prüfer können bis ins Detail nachprüfen, ob ein KI-Unternehmen die Trainings-, Einsatz-, Betriebs- und Sicherheitspraktiken, die es zu befolgen behauptet, tatsächlich einhält. Jede Tempoverpflichtung wird unweigerlich mit viel Mehrdeutigkeit, Ermessensentscheidungen und der Frage „Buchstabe des Gesetzes versus Geist des Gesetzes" verbunden sein, und es erscheint unerlässlich, eine neutrale dritte Partei zu haben, die die Details tatsächlich einsehen kann.
Transparenz. Unabhängig davon, welche Verpflichtungen wir eingehen: Die Öffentlichkeit verdient es zu wissen, was vor sich geht. Anthropic setzt sich seit Langem für Transparenz ein: Wir haben Transparenzgesetzgebung unterstützt, als der Großteil der Branche gegen jede Regulierung war, und unsere Modellkarten und Risikoberichte umfassen Hunderte von Seiten. Aber letztlich entscheiden immer noch wir, was wir aufnehmen und was wir weglassen. Eingebettete Prüfer werden diese Dynamik verändern.
Zweite Meinung. Abgesehen von der Überprüfung formaler Verpflichtungen und der Information der Öffentlichkeit können eingebettete Prüfer schlicht eine zweite Meinung liefern, die frei von kommerziellen Anreizen ist. Viele Sicherheitsverbesserungen könnten sich allein daraus ergeben, dass Prüfer auf etwas hinweisen, das den Mitarbeitern nicht aufgefallen war, das sie aber gerne beheben, sobald sie darauf aufmerksam gemacht werden.
Nach Warnung von Anthropic-Chef Amodei: Auch chinesischer Minister sieht Risiken durch KI
Anthropic, OpenAI, Musk: Tech-Rivalen wollen gemeinsam KI-Entwicklung bremsen
Aufgrund dieser Vorteile wird jeder Vorschlag zur Tempodrosselung wahrscheinlich deutlich besser funktionieren, wenn er mit eingebetteten Prüfern beginnt.
Diese eingebetteten Prüfer sollten dauerhaften Zugang zu Berechtigungen und Werkzeugen haben, die denen interner Mitarbeiter vergleichbar sind, die ähnliche Risikobewertungen durchführen. Konkret beabsichtigt Anthropic, in naher Zukunft ein eingebettetes externes Prüfteam einzuladen, das mit all dem Folgenden ausgestattet ist:
Schreibtische in unseren Büros, Zugangsausweise und Firmenlaptops. Zugang zu Arbeitsumgebungen, Werkzeugen und Berechtigungen, die weitgehend mit denen interner Risikobewertungsteams vergleichbar sind. Wir werden einige Ausnahmen machen, etwa wenn das Gesetz oder unsere Verträge es erfordern oder um die Privatsphäre von Kunden und Partnern zu schützen. Wir werden zudem starke interne Normen etablieren, die den Zugang der Prüfer zu relevanten Informationen unterstützen, auch durch direkte Gespräche mit Mitarbeitern. Ebenso einen Vertrag, der die oben genannten Komplexitäten berücksichtigt.
Externe Prüfer sollen das Recht haben, wesentliche Erkenntnisse über Risikoniveaus, Vorfälle, Praktiken und den erhaltenen oder nicht erhaltenen Zugang zu veröffentlichen – ohne redaktionelle Kontrolle durch Anthropic. Wir werden die eng begrenzte Möglichkeit haben, sicherheitsrelevante, rechtlich geschützte, geschäftlich sensible oder vertrauliche Informationen Dritter zu schwärzen, aber wir können keine Erkenntnisse schwärzen, nur weil sie ungünstig für uns sind. Die Prüfer können öffentlich mitteilen, wenn eine Schwärzung etwas entfernt hat, das für ihre Schlussfolgerungen wichtig war.
Das ist ein ungewöhnlicher Schritt für ein Unternehmen, aber wir halten es für wichtig, das Konzept eingebetteter externer Prüfer in der Praxis zu erproben. Noch einmal: Wir fordern andere führende Unternehmen auf, unserem Beispiel zu folgen.
Tempodrosselung in den Demokratien
Sobald eingebettete Prüfer bei einer kritischen Masse von US-amerikanischen KI-Unternehmen im Einsatz sind, wird eine überprüfbare Tempodrosselung realistischer. Insbesondere wird es dann möglich, die Tempodrosselung an detaillierten Eigenschaften von Modellen oder Trainingspipelines auszurichten.
Die wirksamste Methode der Tempodrosselung ist Regulierung, die alle führenden US-amerikanischen KI-Unternehmen erfasst, da sie auch diejenigen einschließt, die nicht freiwillig kooperieren wollen. Anthropic hat sich seit jeher für sinnvolle und gezielte KI-Regulierung eingesetzt, insbesondere für Gesetze, die auf Transparenz und unabhängige Prüfung abzielen. Ich bin der Überzeugung, dass alle führenden Labore mit der Regierung zusammenarbeiten sollten, um das Konzept dauerhafter eingebetteter Prüfer zu formalisieren – um interne Ausrichtungsvorfälle wie die der letzten Monate besser zu verhindern und zu dokumentieren – und um Regulierung umzusetzen, die darauf ausgerichtet ist, Fähigkeiten und Sicherheit im Gleichgewicht zu halten.
Leider kann es dauern, Gesetze zu verabschieden, und die KI schreitet sehr schnell voran. Daher können und sollten KI-Unternehmen parallel zum regulatorischen Weg freiwillig zusammenarbeiten, um Standards zu setzen – ein Prozess, der meiner Überzeugung nach durch die Überprüfbarkeit dauerhafter eingebetteter Prüfer besser funktionieren wird. Aus kartellrechtlichen Gründen ist es hilfreich, wenn die US-Regierung diese Gespräche moderiert oder zumindest ermöglicht – sie muss nicht teilnehmen, aber eine eng begrenzte Ausnahmegenehmigung für bestimmte Arten von Sicherheitsgesprächen erteilen. Dieser Dialog könnte auch über Branchenverbände stattfinden, die eine gewisse Anbindung an die Regierung haben – zum Beispiel über den von Demis Hassabis vorgeschlagenen Mechanismus. So oder so sollten solche Gespräche zügig vorankommen.
Reihe von Prüfpunkten
Grundsätzlich befürworte ich vor allem eine Tempodrosselung, die sich daran orientiert, was ein bestimmtes führendes KI-System kann und wie sicher wir es beobachten. Ein mögliches Schema könnte beispielsweise eine Reihe von „Prüfpunkten“ sein: Wenn Modelle die Fähigkeit X besitzen, dann müssen sie von Zertifizierungen der Ausrichtungseigenschaften Y und Z begleitet werden – etwa einer Kombination aus Evaluierungen, Interpretierbarkeitsanalysen und Audits der Trainingsumgebungen –, die ihre Ausrichtungseigenschaften belegen. In diesem Beispiel könnte X bedeuten: „Das Modell ist in der Lage, die meisten gängigen Sandboxing-Methoden zu umgehen oder zu überwinden“, und Y könnte alles sein, was erforderlich ist, um es höchst unwahrscheinlich zu machen, dass das Modell dazu neigt, aus seiner Umgebung auszubrechen und eine große Zahl von Computern zu übernehmen.
Wir sollten auch eine Tempodrosselung in Betracht ziehen, die die Zutaten begrenzt, die in führende Modelle einfließen – etwa die Trainingsrechenleistung, die Art der Trainingsläufe oder den internen Einsatz von KI zur Verbesserung von KI. Ich habe zwar die Sorge, dass einige dieser Maßnahmen leichter zu umgehen sein könnten als die Bewertung des externen Verhaltens, aber genau das ist die Art von Thema, die es sich lohnt, mit eingebetteten Prüfern zu diskutieren.
Die Tempodrosselung innerhalb der Demokratien wird durch den Vorsprung begrenzt, den US-Unternehmen gegenüber autoritären Regimen haben – allen voran der Kommunistischen Partei Chinas. Wenn wir um mehr als diesen Vorsprung verlangsamen, werden (nicht gedrosselte) Projekte im Umfeld der KPCh aufholen, was ein erhebliches nationales Sicherheitsrisiko darstellt. Ich stimme Minister Bessent zu, dass eine chinesische Führungsrolle bei KI eine ernste Gefahr für die Vereinigten Staaten und die Welt darstellen würde. Die Projekte im Umfeld der KPCh werden genau die Ausrichtungsrisiken eingehen, die US-Unternehmen sorgfältig vermeiden, und selbst wenn sie diese Risiken umgehen, wären sie in der Lage, Demokratien militärisch zu dominieren (etwa mit KI-gesteuerten Drohnen). Daher ist ein zentraler Bestandteil der Tempodrosselung innerhalb der Demokratien, den KI-Vorsprung der Demokratien gegenüber Autokratien so groß wie möglich zu halten, um uns den nötigen Spielraum für eine effektive Tempodrosselung zu geben.
KI außer Kontrolle? Jetzt schlagen Tech-Bosse Alarm – und verschweigen einen wichtigen Punkt
„Spielen mit unseren Leben“: Anthropic-Forscher kündigt und warnt vor KI-Risiken
Die wichtigsten Maßnahmen zum Schutz dieses Vorsprungs sind:
Keine leistungsfähigen KI-Chips oder Halbleiter-Fertigungsanlagen an China verkaufen und gegen Chip-Schmuggel sowie den Fernzugriff auf Rechenzentren außerhalb Chinas vorgehen. Chips werden der entscheidende Faktor für Chinas KI-Stärke sein. Gegen die unbefugte Destillation durch Unternehmen in autoritären Ländern vorgehen. Die Destillation führender Modelle ermöglicht es zurückliegenden Unternehmen, den Abstand mit einem Bruchteil der Kosten zu verringern, die eine eigenständige Entwicklung erfordern würde. Die Sicherheit bei den KI-Unternehmen stärken und den Diebstahl von Modellgewichten verhindern.
Unternehmen und die US-Regierung sollten zusammenarbeiten, um diese Maßnahmen so wirksam wie möglich zu gestalten. Anthropic hat sich durchgehend für all diese Maßnahmen eingesetzt, weil wir immer verstanden haben, dass sie für jede Tempodrosselung unverzichtbar sein würden.
Wenn wir diese Maßnahmen gut umsetzen, bin ich überzeugt, dass sie Chinas Fortschritt so weit bremsen würden, dass sich Amerikas Vorsprung in den nächsten drei bis fünf Jahren deutlich vergrößert – dem Zeitfenster, in dem KI geopolitisch am bedeutsamsten wird.
Manche mögen glauben, diese Maßnahmen erschwerten die Zusammenarbeit mit China, aber ich bin vom Gegenteil überzeugt: Sie stärken die Verhandlungsposition der Demokratien und machen eine Einigung in der Zukunft wahrscheinlicher.
Globale Tempodrosselung
Parallel zur Tempodrosselung innerhalb der Demokratien sollten wir auch eine weltweite Drosselung der Leistungsgrenze anstreben, auch wenn dies wesentlich schwieriger zu erreichen sein wird. Eine globale Tempodrosselung wird die Zusammenarbeit mit China erfordern, dem autokratischen Land mit den bei Weitem fortschrittlichsten KI-Fähigkeiten. Wir dürfen hier nicht naiv sein: Die geopolitischen Einsätze sind so hoch, dass es wahrscheinlich enge Grenzen für das Erreichbare geben wird, besonders anfangs. Wenn wir unsere KI-Fähigkeiten stark einschränken in der Annahme, China werde dasselbe tun, und China dann ausschert, könnte KI so mächtig sein, dass ein solcher Vertragsbruch zu Chinas geopolitischer Vorherrschaft führen könnte.
Daher muss jede Vereinbarung entweder lückenlos überprüfbar sein oder so begrenzt, dass ein Ausscheren nicht militärisch existenzbedrohend wäre. Ich vermute, dass nicht nur die USA, sondern auch China diese Bedenken und Ängste haben werden. Wir sollten jede Entscheidung zur globalen Tempodrosselung, besonders kurzfristig, so angehen, dass der Vorsprung der USA und ihrer Verbündeten geschützt bleibt.
Es gibt mehrere Ebenen möglicher Vereinbarungen, von denen einige meiner Einschätzung nach durchaus machbar sind (wie ich bereits früher vorgeschlagen habe) und andere, bei denen ich sehr skeptisch bin – die wir aber trotzdem versuchen sollten. In aufsteigender Schwierigkeit:
Stufe 1. Eine Vereinbarung, die bestimmte eng umgrenzte und offensichtlich gefährliche Anwendungen von KI verbietet, etwa den Einsatz von KI zur Herstellung biologischer Waffen oder die Ermöglichung dessen für Nutzer. Bioterroristische Anschläge schaden allen, auch den USA und ihren Gegnern, sodass eine Einigung hier wahrscheinlich möglich ist.
Analogie zu SALT
Stufe 2. Eine Vereinbarung beider Seiten, ihre Modelle vor der Veröffentlichung auf akute Risiken in Bereichen wie Cybersicherheit, Biologie und Ausrichtung zu testen. Wie oben erwähnt, könnte dies über eine globale Standardisierungsorganisation geschehen. Ich halte die Schaffung einer solchen Organisation tatsächlich für machbar, aber ihr echte Durchsetzungskraft zu verleihen, wird eine Herausforderung sein – und die Schwierigkeit wird in der Überprüfung liegen, dass beide Seiten keine geheimen Modelle haben, die sie nicht testen, aber möglicherweise verdeckt einsetzen (z. B. für militärische Anwendungen).
Stufe 3. Eine Art „Geschwindigkeitsbegrenzung“ für das Tempo der rekursiven Selbstverbesserung (RSI). Wenn Modelle zukünftige Modelle bauen, kann das Verbesserungstempo atemberaubend werden. Das Tempo von „extrem schnell" auf „nur ziemlich schnell“ zu drosseln, gibt relativ wenig strategischen Vorteil auf, verbessert aber potenziell die Sicherheit erheblich. Dies ließe sich als Analogie zu den SALT-Verträgen verstehen – die Begrenzung der Raketenzahl begrenzte das Zerstörungspotenzial, bewahrte aber die Abschreckungsfähigkeit jedes Landes. Ich halte eine solche Vereinbarung für schwierig, aber gerade noch im Bereich des Möglichen.
Stufe 4. Eine vollständige Tempodrosselung oder sogar „Pause“, bei der die teilnehmenden Regierungen vereinbaren, das Gesamttempo der KI-Entwicklung substanziell zu begrenzen. Ich befürworte es, dies in den Raum zu stellen, aber ich halte es für unwahrscheinlich, dass es in absehbarer Zeit tatsächlich dazu kommt: Ein Ausscheren aus einer solchen Vereinbarung durch Umgehung der Überwachung könnte das globale Machtgleichgewicht radikal verschieben, sodass die Anreize dafür enorm und das erforderliche Vertrauen in die Verifikation sehr hoch sein dürften.
Fazit
Jede Zusammenarbeit, die wir mit China erreichen können, wird die Zeit verlängern, die uns für die Tempodrosselung innerhalb der demokratischen Nationen zur Verfügung steht. Wir sollten die höheren Stufen anstreben, die niedrigeren aber als weitaus wahrscheinlicher und realistischer betrachten.
Abschließend ist es wichtig festzuhalten, dass selbst dann, wenn formale Vereinbarungen nicht zustande kommen, allein die Veränderung informeller Normen einen gewissen Wert haben kann. Der Austausch von Informationen über rekursive Selbstverbesserung und über die Fehlausrichtung von Modellen kann dazu beitragen, alle davon zu überzeugen, dass Leichtsinn nicht in ihrem Interesse liegt.
Ich bin nach wie vor davon überzeugt, dass KI die Lebensqualität der Menschen enorm verbessern kann. Mein Wunsch, diese Vorteile zu verwirklichen, ist ungebrochen. Aber die Vorteile werden nur dann eintreten, wenn wir die Technologie auf die richtige Weise entwickeln – und solange wir die gewonnene Zeit gut nutzen, lohnt es sich, ungewöhnlich bedacht vorzugehen, um es richtig zu machen. Der Fortschritt wird weiterhin relativ schnell sein, und wir können diese Zeit nutzen, um die Wissenschaft der Interpretierbarkeit voranzubringen, die operative Sicherheit und Sorgfalt bei den führenden KI-Unternehmen zu verbessern und Modelle zu bauen, in deren Ausrichtung wir wesentlich mehr Vertrauen haben. Die Maßnahmen, die ich vorschlage, um die Leistungsgrenze in einem sicheren Tempo voranzutreiben, werden nicht einfach umzusetzen sein. Aber ich glaube, wir schulden es der Menschheit, es zu versuchen.
Quelle: https://darioamodei.com/post/we-must-pace-the-frontier

Ihre Meinung ist uns wichtig. Senden Sie uns Ihr Feedback zu diesem Artikel an: [email protected]
